Drops 教词的方式可以概括成一句话:不给母语翻译,直接把词义绑在图像上。官方称之为 visual association(视觉联想),这是它区别于背单词软件的第一卖点。
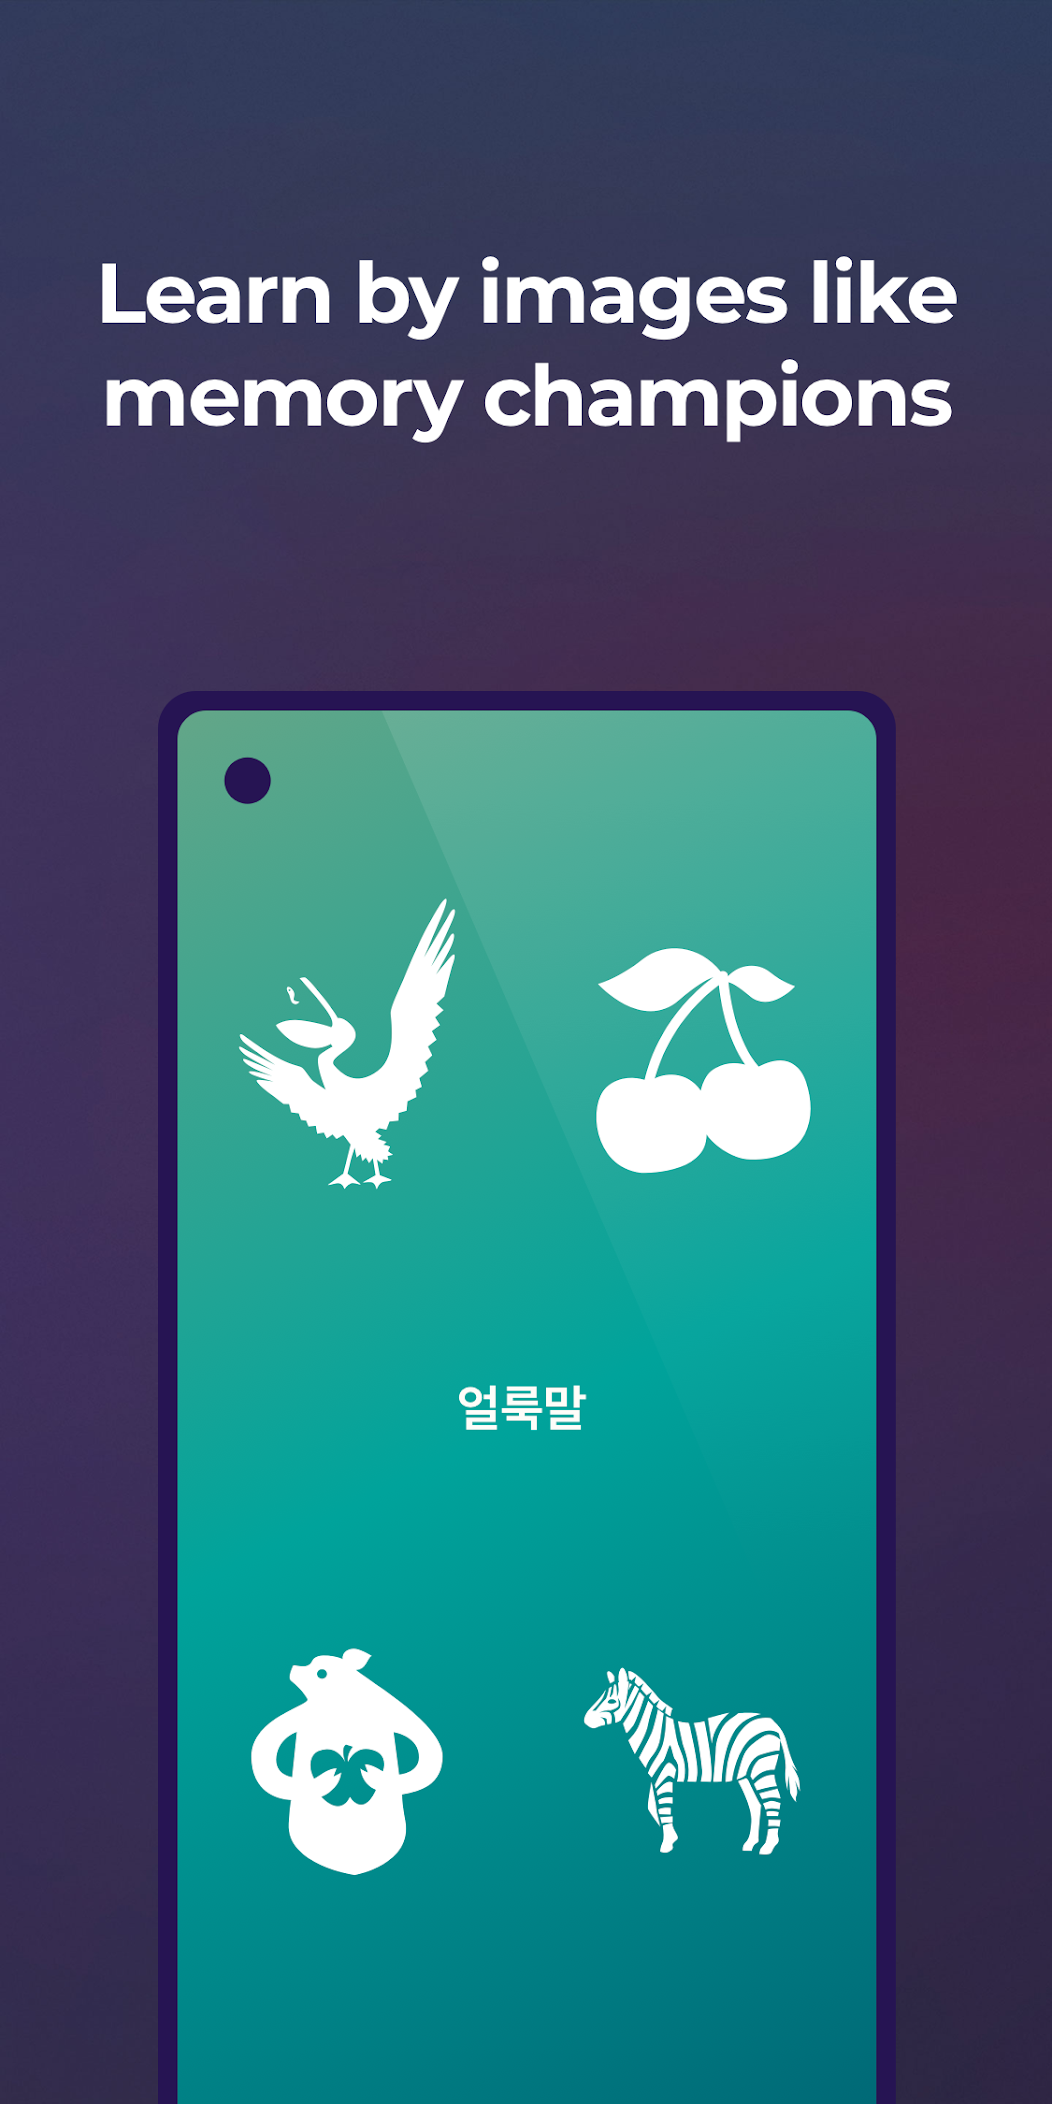
一次完整的学习循环
- 新词出现:插画 + 目标语言发音 + (首次出现的)母语释义。
- 确认是否要学:「你认识这个词吗」——认识的直接跳过,不浪费时间。
- 图像交互:接下来的几轮小游戏只靠图片和目标语言文字判断词义,母语不再出现。
- 间隔重现:这个词会在本次会话与后续复习里按间隔重复出现,直到答对次数达标。
为什么绕开母语翻译
翻译式背诵容易养成「先想中文→再翻过去」的依赖,实际对话里反应速度慢。图像直接承载含义,提取路径更短;对任何母语的用户都成立,这也让 Drops 能以几十种源语言运行。官方还专门为每个词请母语者录音,图-音-形三个通道同时建立记忆。
插画质量是产品力
Drops 的插画由设计团队统一风格绘制,极简、高识别度、无文化歧义。第三方评测几乎都会夸这一点——「把教育应用做成了设计品」。对容易混淆的近义词(比如两种「杯子」),插画会刻意拉开视觉差异。
局限也要知道
抽象概念(比如「然而」「尽管」这类功能词)难以画图,Drops 的处理方式是少收这类词——所以它的词库偏「可视化的实词」:名词、动词、常用短语。这也是它必须搭配综合课程的原因之一。